

而8小时的自由支配时间却是劳动者与资本家几个世纪的斗争换来的;在当下社会,人与人的差距,大多数情况不是由上班8小时时间决定的,而是由除了上班睡觉之外的8小时决定;
在这可以自由支配的8小时里,很多人选择了刷短视频打游戏,而有的人却在利用这些时间提升自己,学习新的技能,努力成为更好的自己


内容来源:本文来自量子教育,企业人才培养优质内容及创新解决方案服务商。 分享嘉宾:赵德旭,SAP中国研究院ECO 2.0人工智能专家组组长,2018年度、2019年度中国数字化领军人物。
责编 | 金木研 排版 | 五月 第 8266 篇深度好文:9987 字 | 25 分钟阅读
宏观趋势
大家好,今天世界各地正在达成这样一种共识:AI是衡量先进生产力核心指标或者是唯一指标。我今天的分享从三个方面进行:
第一,生成式AI为何是新质生产力的核心?这一轮的生成式AI与之前的AI都有哪些本质区别?
第二,为什么AI模型和AI技术不是企业最核心资产,而是私域数据。
第三,如何根据企业不同现状,实现从低成本Prompt应用到建设企业智能体及垂直模型,构建企业核心竞争力。
1.Al进入Iphone时刻
2007年的Iphone时刻,乔布斯2分钟重新定义手机。2023年3月GPT-4发布,预示着Al进入Iphone时刻。
对于它的出现,英伟达CEO黄仁勋说Chat GPT带来AI的iPhone时刻。
Open AI创始人Sam Altman表示这与人类的印刷机相比是同样伟大的发明。
谷歌CEO孙达尔·皮柴( Sundar PichAI)表示这是人类的另一次火和电发明。
比尔·盖茨也表示GPT是他一生中见到的两项最具革命性技术之一。
埃隆马斯克前两天也提到生成式AI比核武器厉害很多倍。
2.人工智能应用场景
接下来我们来看4个实际应用案例。
① 案例:乳业公司瞬时杀菌技术提炼
某乳液公司开发的新款牛奶采用了新的瞬时杀菌技术,那如何将这种新的瞬时杀菌技术转化为销售卖点?
一般情况下,我们会让市场部提炼一个好的卖点语言,这样下来可能需要非常高的价格。
有了人工智能,现在的做法就不一样。具体步骤有:首先,描述背景,了解产品类型。其次,提出要求,如请你帮我思考在卖点过程中需要表达哪些核心内容等。最后,通过逐轮与大模型交互,最终可以得出几个答案。

事实上,提炼这些宣传卖点话术或者宣传用语,如果没有5年市场经验是很难达到这个水平,也许他无法与叶茂中相比,但借助人工智能,还是很容易超越5年内的市场人员。
② 辅助设计,提供创新思路
接下来我们看个服装辅助设计案例。
我们都知道,服装有不同布料、不同颜色以及各种款式。那么,如何快速进行仿真和模拟,实现服装设计过程中的快速、高效迭代和创新?

借助人工智能,如上图所示,我们可以很轻松的进行创新设计。
首先,选择世界上知名的服装风格。其次,选择需要的颜色和细节,例如花岸上衣或其他风格。第三,选好后输入交互信息,如请帮我设计一个礼服,使其看起来更加青春等。
这里需要注意的是,它可以结合很多特点进行细化设计,例如采用了一些经典款式等。
目前,人工智能模型得到进一步发展,如在服装设计过程中,我们在纸上画一个线稿,直接放上去,它会生成整个模特的实际图片。
同时,在展示效果上,如风吹效果,无论是丝绸还是亚麻,还是各种不同布料,都可以根据重量和物理属性,展示出穿着过程中的飘逸感觉,以此判断出设计效果。
③ 某保险客户健康产品推荐
接下来,我们再探讨一个涉及某保险公司与健康检测公司产品推荐的案例。
我们知道,保险业务中,保险人员变动非常频繁,所以,在与客户交互过程中,通过人工智能方式搭建了一个人工智能Agent。
首先,它会读取检测报告中的信息,同时植入专家解读的内容,它会根据专家解读的信息匹配适合的保险产品。此外,它还会借鉴历史销售数据,特别是金牌销售人员的经验,将这些销售经验总结生成话术。
这时,你会发现,保险销售人员会更像一个演员,带着已经准备好的脚本和产品,在客户面前表演。这样,大大提高了我们与客户交互的效率和成效,同时也体现出专业性。
另外,通过自然语言交互,银行人员也可以对自己的信贷进行判断,并与系统、行业指标和各种数据相结合判断信贷风险。这一举措标志着岗位自动化的初步实现。
目前,在AI的广泛应用过程中,我们已逐步从单一岗位的简单任务自动化向复杂任务自动化迈进。在未来2-3年内,会有很多岗位实现全面自动化。
④ 智能招聘助手
我们再看一个智能招聘Agent+RPA+专家知识的综合自动化应用案例。
智能招聘助手可以快速、专业地评价候选人。它会根据JD(岗位职责)要求对应求职者的简历,并针对关键信息给出评价。
为了保证评估的精准性,我们依托丰富的专家背景知识,使招聘助手能够深入理解院校、专业等招聘要素,对候选人作出更为专业的评价。
HR招聘人员可轻松通过后台创建和编辑职位信息,进入招聘页面后,新增岗位、填写JD并一键解析,相关信息将自动填充至相应栏目。
智能助理还能对招聘数据进行深度分析,为HR管理者提供精确的数据支持和结果解读,帮助管理者快速理解招聘现状。
借助智能招聘助手的专家知识库,我们可以更精准地进行简历筛选,并在面试过程中生成个性化的面试题目和答案,确保应聘者与业务需求的精准匹配,并将推荐结果及时送达业务人员。
综上所述,关于人工智能的应用,其核心在于首先推动单岗位任务的智能化升级。
并且,随着技术的不断进步,系统将逐步具备专家的能力,并通过复制和放大这种能力,实现复杂流程的自动化。最终真正为组织赋予新质的生产力。
3.Chat-GPT-4出现,人类可以跟机器自由对话

① 交互方式发生变化
通过对前面讲到的实际应用案例,不难发现,我们的交互方式正悄然发生变化。
第一,DOS命令时代。在那个时期,我们通过输入DOS命令来执行操作。用户需要具备一定的编程知识,通过编写代码来完成任务。
第二,图形交互时代。比尔·盖茨曾赞誉Windows的发明为人类的第二次伟大创新。
图形交互时代的开创性产品Windows,以及后来的iPhone等设备,实现了人与图形界面的直观交互,极大地提高了用户体验。
第三,自然语言交互时代。随着Chat GPT等技术的出现,我们迎来了自然语言交互的新篇章。
Chat GPT具备多种功能,如作画、编写代码、翻译资料、收集信息以及视频处理等,展现了多功能、多模态人工智能的强大能力。通过自然语言交互,用户可以更加便捷地与计算机进行沟通和交流。
② Sora世界模拟器意味着什么?

2024年的2月,Sora在春节期间引起轰动。我们首次在人类视频中看到一位时尚女性走在充满温暖的霓虹灯和动画城市标牌的东京街道。
我们看到生成的视频,此时此刻很难分辨真假,它在霓虹灯底下、湿的、下过雨的地面上的倒影以及各种符合现实世界的情形。
埃隆马斯克在观察Sora出现之后表示:人类应该认赌服输。
Sora世界模拟器意味着什么?
Sora被Open AI定义为世界模拟器,其深远意义超越了简单的视频生成范畴,而是为理解和模拟现实世界提供了坚实基础。
同时,Sora的潜力被认为有助于实现通用人工智能的目标。通用人工智能理论上能够完全取代人类的治理活动。
英伟达高级研究科学家Jim Fa更是直接断言:“sora是一个数据驱动的物理引擎,是一个可学习的模拟器,或世界模型”。
通过先前的与Chat GPT的交流,我们虽然聚焦于文字层面,但未真正涉足物理世界。考虑到我们的三维环境根植于物理法则,Sora的能力显得尤为突出。它能够自主生成图像,进而深化对物理世界的理解。
举例来说,现代机器人装备了摄像头,使其能够捕捉并解析现实的物理环境,包括建筑物、街道以及人与人之间的互动。这不仅让机器人理解物理世界,还促进了数字世界与真实物理世界之间的交互。
Sora的出现之所以引起广泛关注,是因为它为我们提供了一种方法和路径,将数字世界和物理世界的智能打通。
通过Sora,我们正在构建一个反映物理世界真实面貌的模型。
因此,我们说GPT解决了机器与人的自然语言互动,而Sora解决了机器通过摄像头与世界之间的互动。
③ Figure 01更新
2023年3月figure01更新,使GPT拥有身体,机器人拥有灵魂。突出表现在开放式自由交流完全自主判断驱动,没有任何人控制。

如上图所示,它与机器人的互动完全自由,类似于我们之前提到的小米小爱音箱或其他指令式的操作。机器人的动作与真人一样,可以自由应答。
例如,我在桌子上询问他是否可以吃苹果,他直接递给我一个苹果,并回答我说可以帮我收拾一下。
这个过程中机器人的动作完全由自主判断,而非人控制和驱动。它是一种真正的新质生产力和革命性技术。
5.Chat GPT-4出现对人类社会的深刻影响
① 人类社会新物种:人工智能机器人
第一,人工智能机器人。
Chat GPT的出现,我们看到了Sora正在构建一个世界物理模型,这个模型被称为Figure 01,也被称为具身智能。
实际上它与机器人结合,将能够执行那些需要人类身体、智慧和灵魂共同协作的任务。
这一发展标志着人工智能正在逐步且全面地融入我们的社会各个领域。人类社会迎来了一个新的存在,即机器人和人工智能。
第二,人和人工智能相结合物种。
机器人可能还有另一个物种,即人与人工智能机器相结合的生物Cyberman(赛博人,泛指半人半机器的生物)。
在现实生活中,例如通过在人眼中植入芯片,如埃隆·马斯克所研发的New Link,人们已经开始了与机器的初步融合。
更进一步,如果我将此类芯片植入大脑,那我就可以讲各个国家的语言。甚至,如果我将我的眼睛与大脑直接相连,我还能够通过CT扫描进行深入的分析。

② Chat GPT出现,是一场革命性颠覆
第一,人类历史上首次机器理解了人类语言的含义,实现了与人自由对话。
第二,驱动技术发生变化,从技术驱动技术转变为自然语言驱动技术。
在以前,推动技术创新和社会变革的核心力量是那些掌握技术的人群,但技术往往掌握在少数人手中。如今,人类可以借助人工智能通过大白话获取深入的知识和智力。这意味着技术创新不再局限于少数人,而是变成所有人。
因此,我们进入了智力分发的时代。智力就像电能一样,可以赋能给每一个人,这对我们的职业和未来产生巨大影响。
第三,反思教育:什么样的人未来有价值?
什么样的人才能成为未来有价值的人?我们需要反思我们教育。我们的教育不应该是是拷贝式的教育,而应注重培养独立思考、独立认知和独立人格的教育,这才是未来社会所需要的教育方式和能力。
第四,我们开始修正以往的认知。
过去,我们一直自豪地认为人类是上帝发明的最伟大物种,人类大脑必不可少。然而现在,人类的大脑已经不再是必不可少的。
实际上,人类语言比我们所知道的更加结构化和简单,最终可能以相当简单的规则来描述如何组织这样的语言。
GPT发明者伊尔亚·苏茨克维说:GPT的主要思路是通过生成获取世界模型的压缩表示。
沃尔弗拉姆也说:GPT和人类的本质,并没有特别之处。在计算方面,我们与自然中许多系统基本等价。
我们意识到人工智能已经具备人类过去认为独有的创造力和情感判断力。未来AI将逐步发展成自己的世界,这是一个新生态,可能会有自己的宪章,人类需要与之适应、共存共融。

6.决策式AI和生成式AI
① Chat-GPT没出现前,人工智是一种决策式AI
自1950年起,人工智能的发展历程逐渐展开。在ChatGPT之前,我们可以将人工智能视为一种决策式AI。
这种AI主要依赖于输入的大量人类数据和历史数据,通过分析和评估可能的结果来模拟人类的决策过程,从而做出最优决策。它并不自行创造全新的逻辑和内容,而是基于现有数据进行优化。
然而,随着Alphago和特别是Alphago Zero的出现,情况发生了变化。
Alphago在围棋领域取得了巨大突破,打败了世界围棋冠军。尽管它学习了人类历史上的各种棋谱,但其认知和能力并未超越人类总和。然而,Alphago Zero则完全不同。它不再学习人类的棋谱,而是基于简单的规则让机器自行生成不同的棋谱并与自己对战。
经过一段时间的训练,Alphago Zero以100:0的成绩打败了Alphago,这标志着一种全新类型的AI——生成式AI的诞生。
生成式AI不仅限于特定领域,而是具有更广泛的应用范围。例如,2022年至2023年间出现的GPT和Sora等生成式AI系统,它们能够像人类一样进行通用任务智能的处理。
与决策式AI不同,生成式AI能够自行创造全新的逻辑和内容,这使得它们在许多领域都能发挥出色的作用。
② GPT为代表的生成式AI(GenAl)
第一,什么是生成式AI?
生成式人工智能(AI)是一种人工智能,它能够基于输入的数据自行创建、生成新的数据或内容。
与传统的分析型AI不同,生成式AI不仅仅能够理解数据,还能够利用学到的信息创造出全新的、未曾存在的数据实例。
第二,生成式AI的核心能力。
生成式AI的核心能力具体如下图所示:

它具有敢于质疑、连续对话能力、承认不知道、用户意图有效捕捉、提升准确度、上下文理解等能力,同时拥有逻辑判断、推理各种能力。
第三,思维的转变:大力出奇迹-生成式AI的胜利。
整个生成式AI的胜利有一个基本思想,这是我们强化学习之父萨顿的理论。
理查德·萨顿在《苦涩的教训》中指出:历史上AI研究的关键错误在于过分依赖人类的直觉和经验,试图通过精心设计的规则和算法模拟智能。
过去我们犯了一个错误,即人工智能必须按照我们人的规则教给他们。然而今天我们看到利用大规模算力和数据,通过学习算法自主发现解决问题的方法。
AI通过自主学习和大规模算力发现和提炼知识,而非直接依赖人类的显式规则。
当模型足够大时,通过让AI系统自主学习物理世界的运作原理,尝试构建一个能够超越人类直观理解的通用物理世界模拟器。通过它自己学习创建新规则,实现超越人类。
接下来我们来看第二部分,数据是智能之母。
1.人工智能的原理
① 人类大脑:树突和轴突
人工智能的原理可追溯至1888年,卡哈尔因其关于树突棘在神经信号传递中重要作用的推测而获得诺贝尔奖。
此前,人们普遍认为人类在认识事物时能够立即全面把握,然而,通过对大脑神经的显影分析,发现这一过程实际上是逐层传递的,类似于公路交通中必须按照特定路径逐步前行,如先至南京再至徐州。
这一发现为我们理解大脑的认知过程提供了新的视角。

如上图所示,可以观察到右侧图片展示了树突的存在。
每个大脑神经细胞都拥有约1000个不同的连接点,而整个人脑则包含了大约1000亿个这样的神经细胞。这些神经细胞通过庞大的神经网络相互连接和传递信息,通过电信号的激活,形成了人类独特的人工智能。
卡尔尔的研究正是基于这一领域,探索计算机模拟是否能够学习并模仿人类大脑的工作方式。
② 人工智能:神经网络
经过一系列的技术演变与发展,我们今天所称谓的神经网络得以形成。以图像识别为例,如下图所示:

无论是识别人脸还是狗,这一过程并非一蹴而就。相反,它是通过一系列的网络层级,逐步进行边界识别,并在这一过程中捕捉和识别狗的特征,最终作出是否为狗的判断。
在针对狗的实体图像进行识别时,五层网络结构足以应对这一相对简单的任务。
因此,在探讨Sora为何能够理解和重现人类物理世界的现象时,我们发现其关键在于对每个图片进行的精细切割处理。这一过程与神经网络紧密相连。
通过综合判断,Sora根据预设规则将这些图像颗粒进行组合,最终生成视频。这种处理方式使得Sora具备了丰富的物理常识。
例如,当纸飞机撞到树上时,Sora能够准确判断纸飞机无法穿透树木,并因此预测纸飞机会掉落下来。
2.生成式AI快速迭代

2018年GPT 1.0时,其参数规模仅为1.75亿,而到了2019年GPT 2.0时,参数数量激增至15亿。到了3.0版本,参数规模更是飙升至1750亿,这时已展现出相当的智能水平。
在GPT 1.0和2.0时期,Open AI并不被外界看好,甚至有人质疑其真实性。然而,到了3.0时期,智能的表现已经初见端倪。
进入4.0时代,GPT展现出了与人类相似的智能水平,并首次通过了由人工智能之父图灵提出的图灵测试。
图灵测试是衡量机器是否具备真正人工智能的标准,即当人与机器和另一个人通过键盘交互时,如果无法分辨对方是机器还是人,那么就可以认为机器具备了真正的人工智能。
2023年3月,Chat-GPT成功通过了图灵测试,标志着人类迎来了第一个真正的人工智能机器,引起了全球的震动。
此外,2023年12月,Open AI董事会已经开发出了Q星模型,预计参数规模将达到125万亿。
在此背景下,Sam和黄仁勋等人预测,未来五年内将出现通用人工智能,这种人工智能将有可能完全取代人类。
3.未解之谜:智能涌现
在近期对Chat GPT大型模型训练的过程中,我们意外地发现了一个未解之谜:当神经元数量超过100亿时,出现了智能涌现。
这种情况在人类社会中前所未有,它并非简单个体数量的累积,而是产生了质的飞跃。
例如,单个蚂蚁或沙丁鱼并不具备显著的智能,但当蚂蚁集结成群,它们能协同完成极其复杂的工程任务,展现出了超常的智能;同样,尽管沙丁鱼个体的智商不高,但当它们汇集成群时,却能够形成强大的群体运动,有效抵御鲸鱼、鲨鱼和各种风暴的威胁。
虽然我们在动物界中尚未发现与人类智能相匹配的模型,但在模型训练的特定阶段,我们观察到,当神经元数量达到100亿级别时,该模型开始展现出人工智能的特性,能够理解并输出超越原始输入的信息,这一现象令人震惊,并标志着Chat GPT的一次重大突破。

随着神经参数的不断增加,智能水平也在持续提升。与此同时,全球范围内对GPU的争夺愈发激烈,这是因为随着神经元数量的增加,对GPU的需求也在急剧增长。
因此,未来决胜世界的是AI,而决胜AI的又是GPU和硬件。

上图是Jackson于2024年3月3日在《Hacker News》上发表的一篇题为“Revealing Open AI’s Plan to Create AGI by 2027”的报道。
报道概述了Open AI自2022年8月开始训练的一个参数规模达到125万亿的多模态模型。
该模型的第一阶段被称为阿拉基斯(Arakis),亦称作Q星(Q-Star)。
根据报道,Q星计划在2023年已完成48%的智商水平。原计划在2024年达到96的智商水平,2025年则预期达到145的智商水平。
值得注意的是,智商水平是以爱因斯坦的160为参照,全球平均智商水平约为70-80,而较高的平均水平则为110。
因此,当Q星计划的智商水平达到96时,已超越某些地区的平均智商水平。
4.AI技术并不完美
我们看到AI技术为商业领域带来了巨大价值,这一点从英伟达市值突破2万亿美金便可看出。

然而,当前AI技术仍存在不完善之处。例如,上图中在老奶奶吹生日蜡烛的场景中,尽管她正在吹蜡烛,但蜡烛并未移动。同样地,当水杯倾斜时,AI难以准确捕捉水流动的具体时刻。此外,当果汁开始滴落但尚未滴落时,AI也面临着挑战。
这些都显示出AI在刻画物理世界的因果关系方面仍有不足,但随着技术的不断进步和知识的不断积累,AI将迅速取得突破。毕竟,它全天候地在学习全球知识,每一刻都在不断进化。

众所周知,摩尔定律揭示了一个规律:处理器的性能大约每两年就会翻倍,而价格则会减半。
然而,OpenAI的CEO Sam Altman提出了一个全新的观点,他称之为“新摩尔定律”,即宇宙中的智能每18个月就会翻倍。Sam强调,正是这一快速的发展速度,让我们每个月都能感受到前所未有的信息冲击,对我们产生深远影响。
当我们考虑如何训练模型以产生人工智能时,最重要的因素之一是企业的数据和行业经验。这是因为只有借助我们的数据和行业经验,我们才能有效地训练模型,使其产生超越我们自身的智能。
因此,对于任何寻求在人工智能领域取得突破的企业来说,积累和利用自身的数据和行业经验都是至关重要的。
1.AI落地的三种方式

AI在企业的落地过程可以分为三个阶段:
第一阶段,我们采取了一种相对简单直接的方式,即利用当前广泛使用的对话型AI工具,如文心一言、智谱清言和Kimi助手等。
它们可以协助我们完成文章撰写等任务,通过网络便可轻松与之建立联系。
第二阶段,使用AI Agent,即目前AI界最热门的智能体。
AI Agent(人工智能体)是一种能够感知环境、进行决策和执行动作的智能实体。不同于传统的人工智能,AI Agent 具备通过独立思考、调用工具去逐步完成给定目标的能力。智能体可以将大模型的能力与过去掌握的内容、系统知识、判断复杂业务的逻辑等结合起来进行智能组合。
AI Agent和大模型的区别在于,大模型与人类之间的交互是基于prompt 实现的。而AI Agent的工作仅需给定一个目标,它就能够针对目标独立思考并做出行动。
AI Agent通过接收来自外部世界的数据(如环境传感、用户输入等)来感知其所处的环境。通过各类传感器、物联网设备AI可以从物理世界获得信息,通过API接口AI可以从数字世界获取信息。这相当于人类的感觉器官,是智能体与世界建立联系的基础。
处理和分析这些数据之后,AI需要有一定的记忆能力,将当前的环境信息与历史上的决策对比。AI Agent需要具备决策能力,能够基于当前的环境和内置的目标来规划下一步行动,并且在仿真环境中模拟出决策后可能的结果。这类似于人类的大脑思考过程,涉及到理解、规划和解决问题的能力。
决策之后,AI Agent需要将决策转化为实际的动作,可能是通过机械动作操控物理设备,或者是通过API和RPA与其他系统交互。系统交互。执行后的结果又会被用作新的输入,形成一个闭环反馈系统,确保智能体可以适应并优化其行为。
AI Agent不仅是处理信息的工具,更是具备自主学习、适应和创新能力的智能实体,能够在复杂多变的环境中自我优化,并实现目标的有效达成。
在人工智能社会,每个组织和企业是由多个AI Agent组成的智能体,AI Agent从完成单一岗位的自动化到完成复杂任务多岗位自动化。 AI Agent之间还可以相互调用组合。 所以对于企业组织最需要的是智能体的应用和开发,而非大模型。

第三阶段,深入到行业垂直模型的训练。
商用的超大规模模型,如Chat GPT,这些模型是在构建人类社会的数字大脑,而对于细分行业和领域,往往缺乏相应的知识与深度专家经验。目前,许多关键知识仍旧储存于专家的脑海中及组织结构里。
这些行业的私有数据和专业知识是企业的核心资产,正如同每个婴儿所需的母乳,拥有了这些数据,就像拥有了养分,孩子才能健康成长。
因此,每个企业组织都需要建立自己的模型,一方面让企业积累的数据和经验在通用人工智能的助力下孕育出新的智能实体,另一方面通过自建模型,企业能够明确在未来智能体的发展中所需的具体数据类型。
总之,AI落地过程大致会分为这几个路径,需要说明的是,第一阶段是最便宜的方案。
我们可以不花钱或很少的钱直接采用Promt提示词的方式与AI互动,接触到AI世界。然后再根据所需场景开发自己的智能体系,使企业或组织工作从单一岗位自动化逐步实现多岗位自动化,最后搭建并训练属于企业自己的模型。

如上图所示,这就是Promt提示词的交互方式,即我们对话的方式。同时,它也是一个应用工具,我们可以分步骤对problem(问题需求)进行应用和处理。
2.大模型实际落地仍需解决风险问题
目前,大模型在实际落地应用中,仍然存在一些问题。
第一,大模型有时会对某些事物做出错误的判断,甚至存在编谎话,而它本身并不知道他会编谎话。
第二,当我们把核心数据输入到大型模型中时,这些数据很可能会被全球共享,从而导致我们的核心竞争力受损。因此,建立本地的数据库和小型模型变得至关重要。
第三,许多企业正致力于构建自己的数据库,但问题却是用大型模型去生成结果,这样做也会产生风险。
当我们在大型模型中交互时,模型会自动学习并吸收这些内容,进而成为公共知识的一部分。这可能导致我们的核心知识被泄露,因为模型会逐步形成对我们数据的整体画像,无法做到保密。
对企业和组织来说需要拥有私有的知识、经验和技能,以便对其进行有效保护,并实现长远发展。因此,需要建立属于自己的私域模型。
此外,在构建私域模型时,企业或组织应该更关心的是如何在有限的空间和范围内构建模型,而不是构建一个全球性的模型。
从数据处理的角度来看,大概包含约60亿数据的模型就能够满足需求,而这样的模型只需要花费四五十万购买设备和CPU机器就能运行,实际成本并不高。
此外,每个企业和组织都有自己的管理规则、流程和质量控制体系,这些都需要在AI应用中予以考虑。
综上所述,企业在应用AI时,应采取一种综合式的方法。这种方法应涵盖基于人类规则的决策型AI、具备自我创造性的生成式AI,以及内外部数据、系统和人的判断等相结合。
3.Gen AI中应用的层级划分
我们将Gen AI应用分为3层,具体如下图所示:

第一层是L0层,即你对大模型有一定感性认知,我建议大家可以先快速搭建场景、低成本应用之后,再与自己的业务和运营结合,逐步实现多岗位自动化,形成三级体系。

上图是AI最佳实践路径。
为了确保AI技术在企业中发挥最大价值,高层领导需从文化层面进行全面传导。
在定义AI应用场景时,应优先识别出与业务紧密相关的场景,并鼓励具备丰富业务经验的员工参与场景定义。这样,不仅能确保所定义的场景具有实际价值,还能充分发挥AI技术的优势,这非常关键。
以上就是我的分享,谢谢大家!
主办方简介——


(文章略长,来点音乐↑慢慢看吧~)
在创新的征途上,
思维的惯性往往成为阻碍我们前行的枷锁
今天我们看看九宫格分析法
如何突破枷锁打开创新之门
什么是九宫格分析法?


九宫格分析法有什么作用?
如何应用九宫格分析法?
九宫格分析法案例实践


九宫格分析法的适用场景
End
总结与感悟
预测性视角
–远想出宏域,高步超常伦,那些能够预见未来并为之做好准备的人,将能够控制未来。九宫格分析法贯通时间趋势进行分析,鼓励我们以预测性视角看待事情,更能把握未来。
超系统视角
—茶杯里的风暴,在浴缸里不值一提。当解决局部问题遇到阻碍时,不妨从更高维度的超系统出发,或许能构成降维打击。
例如都说冲击方便面市场的是外卖,你如果从本身出发,再研制更方便、更多口味的方便面也抢不回市场,但从超系统的角度来看,他们都是为就餐提供方便,或许就有新的思路夺回一城。

(AI辅助创作)
九宫格,思维的航标,
TRIZ理论的翅膀,带着我们飞高。
过去、现在、未来,时间的河流,
子系统、系统、超系统,空间的辽阔。
啊,九宫格,分析的灯塔,
照亮创新的路,引领我们向前。
全面性、动态性,创新的火花,
问题解决、决策支持,智慧的光芒。
从子系统到超系统,层层深入,
历史回顾,未来预测,时间的穿梭。
创新点,实施策略,九宫格中,
系统化思考,多维分析,智慧的结晶。
啊,九宫格,决策的伙伴,
在复杂中寻找,简单的真谛。
预测性视角,超系统思维,
九宫格法,助我们突破,创新的界限。
啊,九宫格,思维的翅膀,
飞越局限,触摸创新的天堂。
远想出宏域,高步超常伦,
九宫格法,助我们预见,未来的辉煌。
学海无涯,终身探索,
九宫格法,智慧的火种。
愿它照亮,你我前行的路,
解锁创新之门,共创辉煌的篇章。
*上周梳理的黄金圈法则,让我意识到黄金圈法则、5W1H都是关于提问的思维模型,本来想着这周再梳理一个关于系统性提问的。印象中九宫格思维就是从时间和空间的维度能很好、系统地提问和分析。但是没想到梳理下来,又发现一个曼陀罗九宫格和TRIZ理论,这些其实都到了我的盲区。
学海无涯,终身探索吧~
*(欢迎关注,一起学习,共同成长)
愿九宫格法助您突破思维局限、解锁创新之门。懂得过去,看明现在,把握未来。

我想2023年是AIGC技术爆发的一年,AI在通用领域的创作能力,给我们带来了太多的惊喜。同时,AI对人工的替代也让人们出现隐隐的担忧。
正好前段时间阅读了《团队协作的五大障碍》一书,这本书以现代寓言的形式深入浅出地介绍了很多团队管理的知识和方法,于是萌生了通过AIGC辅助创作为视频短片的想法。
1.剧本提炼与设计(经常在网上看到说使用chatgpt生成小红书文案,打造爆品文章)
计划使用chatgpt和Claude等大语言模型,提炼剧本对角色和场景进行设计
2.关键角色和场景的创作
这方面计划采用midjourney,目前公认的效果最好的绘画模型
3.控制场景、人物和角色
由于midjourney难以控制出现的人物,以及环境的一致性,因此计划通过PS和stable diffution来进行控制
4.让图片动起来
采用runaway-GEN2,的图片转视频功能,可以将图片转为4~8s的视频,B站也有很经验的作品
5.配音
现在又听过AI配音的引擎,根据使用习惯,使用了微软Azure TTS以及腾讯智影的文本转语音功能
将原文处理后,喂给AI,让他对角色的形象进行提炼,→转换为AI绘画的提示词。


这一步看起来挺顺利的,主要难点就是控制不同角色生成风格的一致性。
多尝试几次,还都获得不错的效果。
进行场景设计也还不错。


然而,谁能想到,这只是开头最为顺利的一步,后面的过程都没这么顺利。
本来计划还是让AI进行创作;

然而,经过多次的尝试,AI创作都太生硬,而且也出现了与原文出现偏差的情况。

好吧,没办法,还是人工来吧。
于是……还是自己来吧
但原文好歹是10万字的规模,加上我自身文化素养的短板,就造成了另一个问题。
虽然看不上AI,但自己精简的剧本也质量不好,而且费时费力。
整整一个上午过去了,只完成了大概四分之一的剧本,还是比较羡慕AI的速度。那没办法,也不好放弃吧。
于是想着先把前面的剧情做出来,实践一下后续的步骤。
由于midjourney难以控制任务和环境的一致性,于是准备像控制更好的stable diffution来辅助创作。
然而stable diffution的可控性来至于复杂的参数设置。
总之,从安装到不停尝试,以及解决本地部署的一些问题,一下午过去了。然而一张满意的图片都没有……
不仅没有控制好人物,而且整体效果也比midjourney差。

因此,退而求其次,还是转向midjourney,做一些有相似性的创作。
用PS将角色形象,贴到场景中,然后使用垫图模式进行创作。

可以看到,midjourney很难话准确的一个角色,然而没办法只有这样了,因为已经从中午来到晚上了。

恩,可能因为选择的整体风格原因,将图片给GEN2转视频时,远远达不到B站其他作品的效果。
后来,干脆就不用了。。。。
这部分终于有回到相对顺利,现在又很多AI配音的工具,提供了很多模型引擎,就是选择符合角色形象的就行。
总的来说,这部分还过得去。
单这些配音更多都是用于阅读和解说,用于剧情的对话,还是显得有些生硬。而且没有情绪。
我给COO尼克选了一个温文儒雅的配音,结果剧情中有一段是喝米琪吵架。
结果他还是温文儒雅,慢吞吞………………
一言难尽了。
动画制作远比想象的复杂得多,以目前的AIGC能力来讲,很难补上短板;
AI有很强的效率和进化能力,一旦习得,效率超强,我们应该拥抱AI能力,否则可能真的会被会AI的同行甩出几条街
虽然出现过写PRD的AI,但是在我看来还是有点小儿科了,也希望在我本职的产品管理领域,出现更亮眼的AI应用
真是一个充实的周末,恩,为了这11分钟的短片,还是投入了很多时间。
感谢我的带娃合伙人,承担带娃任务,让我闲暇时间做一次有趣的尝试。
最后,还是看一下成果吧

Prologue
美国一专栏作家迈克·西蒙斯研究了数年多名亿万富翁的信息获取策略后发现,信息与知识存在等级之分。高层次信息更值得投入关注与收藏。社交媒体虽有价值,但优质内容稀缺,多为即兴之作。相比之下,书籍汇聚了作者深思熟虑的精华,而书籍摘要则进一步提炼核心思想。领域摘要则更为全面,概括了某一领域的精髓。最顶端的是思维模型,如“二八原则”,它不仅适用于单一领域,还能跨界应用,揭示投入与产出、财富分配的普遍规律。

那么我们先来复习(应该大多数人都知道了)一下西蒙斯提到的二八原则
01
二八原则讲了什么?
二八原则最初由意大利经济学家维尔弗雷多·帕累托在19世纪末提出。他发现,大约20%的人口拥有80%的财富。

后来,这一概念被推广应用到各个领域,总结为:20%的投入/原因/努力往往能产生80%的收获。
20%的优秀员工,创造80%的业绩
20%优势项目,创造公司80%的利润
20%的高效时间,完成80%的工作
……
02
为什么会产生这种不均衡的分配呢?
那么,为什么会产生二八分配呢?
其背后的原理与自然界中非线性关系和幂律分布有关。
在自然界中,有很多事件是独立和随机的,他们就会呈现正太分布(这个我们应该最熟悉了),但是像财富分配这样,他们之间是有相关性的,例如一个人越有钱,那么你会感觉他赚钱越容易,钱和钱存在相关性,而不是每一块钱随机给某个人赚,那么在有序且相关的情况下,那么就会服从幂律分布。

于是就出现了分配的极大不平衡,甚至现在网络流行的一个段子,新的二八定律为:
2%的人掌握了98%的财富
所以在充满相关性的社会中,也就充满了不平衡的分布,也就是二八原则在多个领域和场景中都有体现的原因。

03
如何应用二八原则?
例如在产品管理中,产品经理往往会收集到很多的需求、功能、建议。那么你看,一款产品20%的核心功能往往可以决定80%的用户满意度,们是不是应该识别出核心功能,更有效的分配资源提升产品竞争力?
80%的产品问题,可能就是20%的bug引起的,我们就应该优先解决这些问题,而不是头痛医头脚痛医脚,手忙脚乱。
例如在市场营销中,二八原则帮助企业识别并维护那20%的高价值客户,他们往往贡献了大部分的销售额。通过提供定制化的服务和解决方案,企业能够实现更高的客户忠诚度和利润率。
04
在哪些情况不能使用二八原则?
当然,二八原则并不是万能的。它并不适用于所有情况,尤其是在以下场景下:
平等性重要的场景:在需要保证公平对待所有人的环境中,二八原则可能并不合适,如法律和教育等领域。
线性关系场景:如果一个系统中的产出与投入成正比,即没有明显的非线性特征,那么二八原则可能并不适用。
完全随机的环境:在某些随机或不可预测的情况下,如自然灾害的发生,二八原则就失去了解释和预测的能力。
05
总结
在我们纷繁复杂的世界中,这条原则揭示了不平等的普遍性,为我们提供了一种洞察事物本质的独特视角。
二八原则是一个强大的思维工具,它能帮助我们认识到资源分配的不均衡性,从而在诸如产品管理等领域中作出更明智的决策。然而,它并不是一成不变的法则,我们在应用时需要结合实际情况,才能发挥最大的效用。当我们理解并妥善运用这一原则时,便能以较小的努力收获丰硕的成果,实现效率与成效的最优化。
世事纷乱,多分二八;
数量虽少,贡献却大。
财富成效,隐于其间;
说服决策,少数关键。
学海无涯,先学二八,
抓住关键,以小博大。
*(本文AIGC辅助创作)
*立个flag,每周学习梳理一个思维模型,关注我,监督我,共同学习~

这是我使用最多也收益最多的一个思维模型,接触到这个模型要追溯到高中时代,到现在已经超过15年了。那个时候需要学习写议论文,有一次跟一个同学交流,他分享了一个从另一位老师那里得到的经验,对于有一段背景信息的议论文,需要从三个层面来阐述。是什么→为什么→怎么办,这其实就是5W1H模型的基础,基于这个基础我把这个模型一直用到了现在。
01
5W1H思维的基础
面对一个信息/现象/热点或者趋势,往往需要落地到对我有什么影响,我应该怎么应对,才算对这个信息的完整响应,这也是高中最常出现的作文形态,给一段介绍,让你写一篇不少于800字的作文论述。
面对这样一个背景,我们往往可以从求真、求知、求解三个方面来着手,也就是阐述是什么、为什么、怎么办。

这其实就是5W1H中的2W1H(What、Why、How),虽然一般介绍没有这一说法,但我就是这么了解和学习这个模型的,仅供大家参考。
但最基础2W1H(是什么、为什么、怎么办)在落地的时候还是会有遗漏的地方,例如怎么办还缺少很多维度,谁怎么办、什么时候在哪里怎么办,描述是什么的时候,加入另外的维度也会更清晰。
这就进入到了5W1H模型
02
什么是5W1H六何分析法?
5W1H,即“六何”分析法,是一种通过提出并回答关于事件或问题的六个基本问题来获取全面信息的方法。在探索问题的本质和寻找解决方案的过程中,5W1H分析模型以其简洁而高效的特点,成为了一个不可或缺的工具。
这个模型通过回答六个基本问题——Who(何人)、What(何事)、When(何时)、Where(何地)、Why(为何)和How(如何),帮助我们全面而深入地理解情境,从而做出更加明智的决策。

这一模型的起源可追溯至古希腊哲学家亚里斯多德的”元因学说”。
在19 世纪末,新闻记者们使用这种方法来收集和组织新闻信息。
经过多年的演化,5W1H不断演化,逐渐成为了一种清晰、实用的分析方法。它深入浅出,条理清晰,帮助我们更好地理解复杂问题的本质,并从中获得深刻洞见。
03
为什么5W1H能洞察问题本质?
有人说5W1H教会了他所有的事情,
有人说5W1H能问尽世间一切问题,
还有人说5W1H能洞察问题本质
为什么它能?
仔细分析5W1H所问的六个问题,其实涵盖了时间、空间、人、物、因果和变化等六个方向,而这六个方向,所能涵盖的范围就太广了,我想这就是这个模型能应用如此广泛的原因。

04
如何应用5W1H六何分析法?
5W1H 分析模型应用范围极其广泛,从市场调研到产品设计,从项目管理到战略规划,几乎涵盖了所有需要分析和决策的领域。通过回答这六个基本问题,决策者能够全面地审视问题,识别潜在的机遇与挑战,并制定出切实可行的解决方案。它可以用于以下场景:
识别问题:通过全面的信息收集,明确问题的本质。
制定计划:确定行动方案的每一个细节,确保计划的可行性。
提高效率:通过系统分析,避免不必要的错误和重复工作。
促进沟通:确保信息的准确传达,减少误解和沟通成本。
优化流程:通过分析每个环节,找出改进和优化的机会。
从是什么、为什么、怎么办三个问题扩展到5W1H的六个问题,其实有可能是基于是什么的扩展也有可能是基于怎么办的扩展。因此,5W1H所分析的主体在不同应用场景中也不尽相同。
例如我们在识别问题,收集信息的时候,When代表着问题发生的时间、Where代表问题发生的地点;然而在我们制定计划的时候,When却可以代表什么时候执行、Where代表在哪里执行。
因此5W1H分析模型简单、强大、适用性强,但同时这个模型也相当于一套心法,不同人使用的效果也不一样,我们需要不断地应用和练习,使用得越熟练,模型的威力越大。
05
哪些场景不适合5W1H分析?
尽管5W1H模型在许多情况下都非常有用,但它并不适用于所有场景。例如,在需要快速反应的紧急情况下,花费时间详细分析每一个“W”和“H”可能不切实际。此外,当信息不足或情况不断变化时,过分依赖5W1H模型可能会导致决策延迟。
06
7W3H1E六何分析法的进一步扩展
由于5W1H广泛的适用,不同的人把他应用到不同场景中,在一些具体的场景对这六个问题也进行了扩充,有的在说5W2H,6W3H甚至7W3H1E。大家视情况选择分析即可:

07
后记
5W1H,追究事实,获取新知
英国作家拉迪亚德·吉卜林(Rudyard Kipling)在《Just So Stories》中已经写了一首关于5W1H的诗篇,这个模型的总结就不找AIGC合作写诗了。直接以原诗结尾吧:
I keep six honest serving-men
(They taught me all I knew);
Their names are What and Why and When
And How and Where and Who.
I send them over land and sea,
I send them east and west;
But after they have worked for me,
I give them all a rest.
I let them rest from nine till five,
For I am busy then,
As well as breakfast, lunch, and tea,
For they are hungry men.
But different folk have different views.
I know a person small–
She keeps ten million serving-men,
Who get no rest at all!
She sends’em abroad on her own affairs,
From the second she opens her eyes–
One million Hows, two million Wheres,
And seven million Whys!
附
模型逻辑图


引言
“无论我去哪家公司,我都能经营下去。因为我能推动PDCA”——田汽车前董事长 奥田硕

PDCA是什么?
D执行和A处理有什么差异?

为什么说它能经营任何公司?
PDCA有什么魅力,为什么奥田硕认为,推动好他能经营任何一家公司?
1.大道至简,PDCA可广泛应用于不同颗粒度的问题和项目。


PDCA在哪些场景适用?
在哪些场景不适用?
#End
summarize
(*今天suno ai好卡,生成歌曲用了好久)
(Verse 1)
在这无尽的追求里,我们寻找答案
PDCA的光芒,照亮我们的道路
计划、执行、检查、行动,循环不息
这是成功的秘诀,也是智慧的结晶
(Chorus)
PDCA,你的名字如此响亮
在你的指引下,我们勇往直前
PDCA,你的力量如此强大
在你的怀抱里,我们共同成长
(Verse 2)
我们在质量的海洋里,乘风破浪
PDCA的风帆,引领我们前行
每一个环节,都经过精心的打磨
每一个细节,都闪耀着智慧的光芒
(Bridge)
PDCA,你是我们的灯塔
在黑暗中为我们指引方向
PDCA,你是我们的伙伴
在困难中与我们并肩作战
(Chorus)
PDCA,你的名字如此响亮
在你的指引下,我们勇往直前
PDCA,你的力量如此强大
在你的怀抱里,我们共同成长
(Outro)
让我们一起,跳起PDCA的舞蹈
在这追求卓越的旅程中,永不言败
PDCA,你将永远在我们心中
因为你,我们将无往不胜

(本文略长,来点儿音乐↑慢慢看~)
为什么有些信息能迅速抓住听众的注意力,
而有些则如泥牛入海?
这背后隐藏着怎样的逻辑和结构?
什么是金字塔原理?

金字塔原理有什么作用?
如何应用金字塔原理?
1
基本原则
2
MECE让金字塔结构完整

3
SCQA让表达吸引人

实践练习一下
1
自下而上地思考


2
自上而下地表达
有哪些适用和不适用的场景?
End

*(本文仅代表个人观点)

为什么有些人总能高效地完成任务,
而有些人却总是手忙脚乱?
答案可能就藏在艾森豪豪威尔矩阵中
什么是艾森豪威尔矩阵?

艾森豪威尔矩阵有什么用?
其最大的作用就是可以帮助我们高效管理时间,让自己的一段时间度过得更有价值,避免忙忙碌碌,但碌碌无为的情况。
为什么这个思维模型有用?
如何在工作和生活中应用?


实践练习一下
梳理任务和分类
按策略执行
1.立马着手采购食材,和客户投诉
复盘与优化
1.重要且紧急的事情偏多
模型有哪些局限性?
END
总结与感悟

时间指挥官·艾森豪威尔矩阵之歌
(AIGC辅助创作)
*下期预告:GTD(Getting Things Done)模型,艾森豪威尔矩阵针对每一类的事务只是一个方向性的策略,实际操作下来可能和理想差距很大,而GTD思维模型则在此基础上更具备可操作性一点,我们下一期就尝试一起来学习这个模型吧

(文章略长,来点音乐↑慢慢看吧~)
引言
上一期我们讲了一个时间管理模型——艾森豪威尔矩阵,这期我们继续来讲一个更具备操作性的时间管理模型,GTD时间管理。
什么是GTD?

GTD方法有什么用?
为什么GTD有用?
如何应用和实践GTD?

1
收集(Capture)

2
整理(Clarify)

3
组织(Organize)


4
回顾(Review)

5
执行(Act)


GTD总体流程


GTD的适用场景和局限性
End
Summary
GTD之歌
(AIGC辅助创作,文章开头音乐的歌词)
哦,生活的节奏,快速而紧张
任务堆积如山,我该如何是好?
GTD,我的朋友,你是我的指南
在纷扰中找到宁静,这是我的生活
(第一节)
每一天,任务不断,像潮水涌来
收集箱里,思绪乱舞,我该如何安排
任务清单,我的助手,记录每一个想法
GTD,你告诉我,下一步该怎么走
(副歌)
It’s my life, it’s my time,
掌控每分每秒,这是我的人生
It’s my life, it’s my choice
GTD引领我,走向高效和自由
(第二节)
整理思绪,清晰每个任务
项目、行动、等待,分类明确
回顾日程,审视每个决策
GTD,你引导我,保持专注和冷静
(副歌)
It’s my life, it’s my time,
在繁忙中找到秩序,这是我的人生
It’s my life, it’s my choice
GTD伴随我,实现梦想和目标
(结尾)
当夜幕降临,任务一一完成,
心满意足,明天又是新的挑战
GTD,感谢你的陪伴,
这是我的生活,我主宰。
最后,祝大家轻松工作,搞定一切!
*本文仅代表个人观点,仅供参考
*近期都在梳理思维模型,大家有想要了解的思维模型,或者想看看什么场景下有没有思维模型可用,可以给我留言~
*(欢迎关注,一起学习,共同成长)

它是乔布斯让苹果红遍全球的底层逻辑
被誉为世界上最有影响力的思维模式
它为什么有如此魅力?
什么是黄金圈法则?

黄金圈法则有什么作用?
如何引用黄金圈法则?

黄金圈法则的应用案例

我的疑惑与思考

黄金圈法则实践
#后记
The end

黄金圈法则之歌
(文章开头音乐的歌词,AIGC辅助创作)
Why, Why, Why我们问,
为什么开始,心里最深。
How, How, How我们行,
怎么做路径,步步为营。
What, What, What我们做,
做什么行动,显于外头。
黄金圈法则,简单又明了,
从内到外走,顺序不颠倒。
Why是核心,How是桥梁,
What是果实,挂满枝头。
黄金圈法则,引领向前行,
Why, How, What,成功的秘密。
心有所向,手有技巧,
行动展现,梦想成真了。
每个故事,都有自己的Why,
每个梦想,都需要How去追。
每份成就,都源于What的积累,
黄金圈里,我们共同成长。
记住Why,How和What,
顺序正确,思路开阔。
黄金圈法则,指引方向,
引领我们,走向辉煌。
Why, Why, Why我们问,
心中有爱,世界就温暖。
How, How, How我们行,
脚踏实地,梦想能成真。
What, What, What我们做,
行动一致,成功在望中。
最后祝大家志在青云,成就不凡,卓越人生!
*本文仅代表个人观点,仅供参考
*(欢迎关注,一起学习,共同成长)
大家好。本公众号覆盖数据分析、可视化、大模型等多个方向实用技巧分享,欢迎大家关注,具体可查看下面文章:
如果对你有帮助,还请关注下面公众号点赞关注转发,你的支持就是我创作的最大动力~
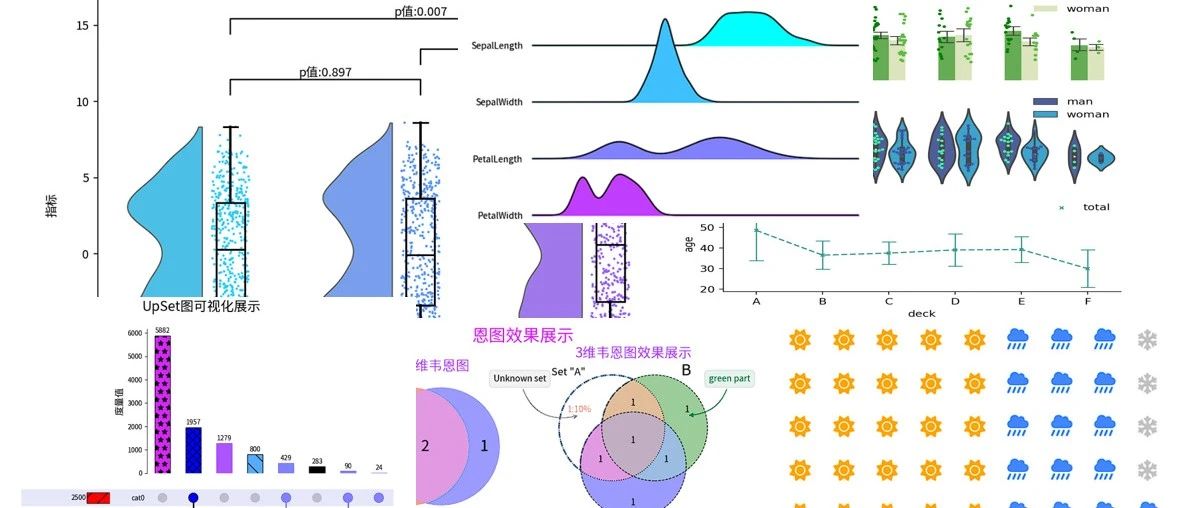
今天给大家分享数据分析高达17种高级图表可视化,并附带详细的python案例,干货满满~本文涉及的python库版本信息如下:
# !pip install great_tables==0.5.0
# !pip install polars==0.20.18
# !pip install mpl_font==1.1.0
# !pip install pywaffle==1.1.0
# !pip install ptitprince==0.2.7
# !pip install matplotlib_venn
# !pip install upsetplot==0.9.0
# !pip install plottable==0.1.5
# !pip install pyjanitor==0.26.0
# !pip install pynimate==1.3.0
背景介绍
华夫图绘制
瀑布图精美可视化
云雨图+显著性展示
分组统计柱状图使用seaborn库快速实现分组统计柱状图
热力图:利用biokit库绘制精美热力图
同类型不同阶段对比图:使用双系列重叠图表示
滑珠图: 绘制滑珠图展示不同产品2个阶段的对比
多集合可视化效果使用韦恩图进行(2~3)维展示
UpSet图精美可视化展示
绘制精美表格图例
绘制精美表格迷你图
决策树模型结构精美可视化展示
使用dtreeplot库精美展示树模型结构
使用dtreeviz库精美展示树模型结构
使用pybaobabat库精美展示树模型结构
绘制数据分析指标拆解树
对dtreeplot的绘图代码进行解析
照猫画虎仿照绘制指标拆解树
最终输出结果
绘制精美展示山脊图和多维直方图
展示多维山脊图
展示多维直方图
动态图表: 利用Pynimate轻松绘制绘制
matplotlib实战基础教程
参考文档
PyWaffle库(其官方github:https://github.com/gyli/PyWaffle)是基于matplotlib库进行二次开发。主要用于绘制华夫图(象形图),只需要一行代码即可快速绘制,其支持高达2k多种象形图标。下面是常用的案例介绍
import matplotlib.pyplot as plt
from pywaffle import Waffle
data = {"sun": 30, "showers": 16, "snowflake": 4}
fig = plt.figure(
    FigureClass=Waffle,
    rows=5,
    values=data,
    colors=["#FFA500", "#4384FF", "#C0C0C0"],
    icons=["sun", "cloud-showers-heavy", "snowflake"],
    font_size=20,
    icon_style="solid",
    icon_legend=True,
    labels=[f"{k}:{v}({int(v / sum(data.values()) * 100)}%)" for k, v in data.items()],
    legend={ "ncol": len(data),"loc": "lower left", "bbox_to_anchor": (-0.05, -0.2),
            "frameon": False,"fontsize": 12,'labelspacing':0.2,}
)
效果展示

瀑布图(Waterfall Chart)是一种专门用于表现数据在一系列变化后累积效果的图表类型,它通过一连串的垂直条形来可视化数据随时间或其他顺序变量的变化过程,尤其强调从一个初始值到最终值之间每个阶段对总体数值的贡献或影响。下面是利用python绘制的瀑布图。
index = ['初始值','1月份','2月份','3月份','4月份','5月份']
b = [10,-30,-7.5,-25,95,-7]
pf= pd.DataFrame(data={'A' : b},index=index)
pf['B'] = [20,10,-40,30,20,-10]


import mpl_font.noto
fig,axes = plt.subplots(2,1, figsize=(8,6), dpi=144)
ax = axes[0]
ax = waterfall_chart(pf,col_name='A',
    ax=ax, formatting='{:,.2f}',
    rotation_value=0, net_label='最终值',
    Title='瀑布图可视化展示', x_lab='月份',  y_lab='产量'
    )
ax = axes[1]
ax = waterfall_chart(pf,col_name='B',
    ax=ax, formatting='{:,.2f}',
    rotation_value=0, net_label='最终值',
    Title='瀑布图可视化展示', x_lab='月份',  y_lab='产量',
    green_color='#4BC0E7', red_color='#A07AED', blue_color='#C04BE7',
    )
plt.show()
可视化展示
云雨图(Raincloud plot)是一种结合了多种图形元素的统计图表,用于更全面地展示数据分布特征以及多个组别之间的比较。它通常包括以下几个组成部分:
云(Cloud):这部分采用核密度估计(Kernel Density Estimation, KDE)来描绘数据的概率密度分布,类似于小提琴图(Violin plot),但有时可能只显示一侧或者经过修改以减少视觉混乱。
伞(Umbrella):即箱线图(Boxplot)的部分,显示了数据的四分位数(最小值、下四分位数、中位数、上四分位数、最大值),概括了数据的基本集中趋势和离散程度。
雨(Rain):散布在箱线图下方的点状图,展示了每个数据点的位置,有助于观察单个数据值相对于整个分布的情况。
import mpl_font.noto
import matplotlib.pyplot as plt
from ptitprince import PtitPrince as pt

fig, ax = plt.subplots(figsize=(10, 6), dpi=144)
dy = "A"; dx = "Category"; ort = "v"

# 显示一半小提琴"云图"
ax=pt.half_violinplot(ax=ax, data = df, palette = "cool", bw=.2,  linewidth=1,cut=0.,scale="area", width=.8, inner=None,orient=ort,x=dx,y=dy)
# 显示点状图"雨图"
ax=sns.stripplot(ax=ax,data= df, palette="cool", edgecolor="white",size=2,orient=ort,x=dx,y=dy,jitter=1,zorder=0)
# 显示箱型图
ax=sns.boxplot(data= df, color="black",orient=ort,width=.15,x=dx,y=dy,zorder=10, showcaps=True,boxprops={'facecolor':'none', "zorder":10},showfliers=True,whiskerprops={'linewidth':2, "zorder":10},saturation=1)

# 进行单边t检验&&绘制对应的效果
y= df['A'].max() + 0.8;h= 1;col = 'k'
pairs = [('type_A', 'type_B'), ('type_B', 'type_C'), ('type_A', 'type_C')]
for i, (group1, group2) in enumerate(pairs):
    group1_values = df[df['Category'] == i]['A']
    group2_values = df[df['Category'] == i+1]['A']
    _, p_value = ttest_ind(group1_values, group2_values)

    x1, x2 = groups.index(group1), groups.index(group2)
    ax.plot([x1, x1, x2, x2], [y + (h*i), y + h + (h*i), y + h + (h*i), y + (h*i)], lw=1.2, c=col)
    ax.text((x1+x2)*.5, y+h+(h*i), f'p值:{p_value:.3f}', ha='center', va='bottom', color=col)
    y += h

# 配置坐标轴
ax.set_ylim(-11, y+h+3*h)
ax.set_xlim(left=-0.7, right=3.5)
ax.set_xticklabels(['type_A','type_B','type_C','type_D'],ha='right',rotation = 0,fontsize = 12) # 设置刻度标签
ax.set_title('云雨图+箱型图+显著性可视化展示',y=1.01)
ax.set_xlabel('不同类型')
ax.set_ylabel('指标')

ax.grid(False)
ax.spines["top"].set_visible(False)
ax.spines["right"].set_visible(False)
fig.tight_layout()
plt.show()
可视化结果:
下面是利用seaborn库快速实现分组统计柱状图,对应的python案例如下。
import seaborn as sns
import numpy as np
import matplotlib.pyplot as plt
import matplotlib
import warnings
print("matplotlib:", matplotlib.__version__)
warnings.filterwarnings("ignore")
titanic = sns.load_dataset("titanic")
df = titanic[titanic['who'].isin(['man','woman'])].query("deck!='G'")
print(df.describe())
from pandas.api.types import CategoricalDtype
df['deck']=df['deck'].astype( CategoricalDtype(categories=['A','B','C','D','E','F'], ordered=True))
df['deck'].unique()

f,axes = plt.subplots(3,1, figsize=(6,6.5),dpi=200, )
ax =axes[0]
ax=sns.barplot(data=df, x="deck",
               y="age", hue="who", errorbar=("ci", 85),estimator=np.mean,
               palette=['#5CBB45','#DEEBB5'],
               capsize=.2,
               width=0.5, #设置柱状图的宽度
               errwidth=1,
               ax=ax,orient='v',) #estimator=np.mean, ci=85,

sns.stripplot(data=df, x="deck",
              y="age",hue="who",dodge=True,jitter=True, ax=ax,
               palette=['green','#5CBB45'],size=3,orient='v',legend=False)
h, l = ax.get_legend_handles_labels()
ax.legend(h, ['man','woman'],ncol=1,frameon=False,loc='upper right')
ax.spines['right'].set_visible(False)
ax.spines['top'].set_visible(False)
ax.spines['bottom'].set_visible(False)
ax.axes.xaxis.set_visible(False)

ax =axes[1]
sns.violinplot(data=df, x="deck",hue="who",palette=['#4057A8','#22AFE5'],
              y="age",dodge=True, ax=ax,orient='v',legend=False)
ax=sns.swarmplot(data=df, x="deck",hue="who",size=3,palette=['#40F7A8','#4057A8'],
              y="age",dodge=True, ax=ax,orient='v',legend=False)

h, l = ax.get_legend_handles_labels()
ax.legend(h, ['man','woman'],ncol=1,frameon=False,loc='upper right')
ax.spines['right'].set_visible(False)
ax.spines['top'].set_visible(False)
ax.spines['bottom'].set_visible(False)
ax.axes.xaxis.set_visible(False)
ax.set_yticks([20*i for i in range(6)])
ax.set_yticklabels([20*i for i in range(6)])

ax =axes[2]
ax=sns.pointplot(data=df, x="deck", y="age", orient='v',dodge=True,
                  markers= "x",linestyles= "--",errwidth=1,
                  errorbar=("se",3 ),  capsize=.2, scale=0.5, ax=ax,color='#43978F',join=True,label='total') #['#43978F','#ABD0F1']

h, l = ax.get_legend_handles_labels()
ax.legend(h, ['total'],ncol=1,frameon=False,loc='upper right')
ax.spines['right'].set_visible(False)
ax.spines['top'].set_visible(False)
plt.subplots_adjust(hspace=0.1)
plt.show()
可视化结果:

当你需要展示二维数据的整体变化趋势时,你可以使用biokit库(https://github.com/biokit/biokit)来进行可视化展示,下面是一个案例分享;
# !pip install biokit==0.5.0
import pandas as pd
import numpy as np
from biokit.viz import corrplot
fig = plt.figure(figsize=(6,4),dpi=200)
fig.subplots_adjust(left=0.1, wspace=0.06, hspace=0.06)
ax1 = fig.add_subplot(221)
ax2 = fig.add_subplot(222)
ax3 = fig.add_subplot(223)
ax4 = fig.add_subplot(224)
df = pd.DataFrame(dict(( (k, np.random.random(10)+ord(k)-65) for k in ['A','B','C','D','E','F','G'])))
df = df.corr()
c = corrplot.Corrplot(df)
c.plot(fig=fig, ax=ax1, colorbar=True,method='circle', shrink=.9,lower='circle', label_color='red'
       ,cmap='cool')
c.plot(fig=fig, ax=ax2, colorbar=True, cmap='crest',method='square', shrink=.9 ,rotation=45)
c.plot(fig=fig, ax=ax3, colorbar=False, cmap='copper', method='text',)
c.plot(fig=fig, ax=ax4, colorbar=True,  method='pie')
plt.show()
可视化结果:
下面是一个案例展示利用双系列重叠图表示同类型不同阶段数据指标的变化情况。
from mplfonts.util.manage import use_font
use_font('Noto Sans CJK SC')
import matplotlib.pyplot as plt
import mplcyberpunk
import numpy as np
x = ['%d月'%i for i in range(1,13)]
y1 = np.array([45, 63, 49, 45,53,45,67,64,73,84,64,55])
y2 = np.array([25, 93, 29, 85,63,25,47,84,43,94,34,25])
# DCE9F4', '#E56F5E', '#F19685','#FFB77F',  '#F6C957',  '#FBE8D5']
with plt.style.context("cyberpunk"):
    use_font('Noto Sans CJK SC')
    fig, axes =plt.subplots(2,1,figsize=(6,2.5),dpi=200)
    ax =axes[0]
    ax.set_title("产品A实际完成和预计完成情况", fontsize=8)
    delta_list = np.array([round((y2[i]-y1[i])/y1[i],4) for i in range(len(y1))])
    colors =  np.array(['#E56F5E' for _ in range(len(x))])
    colors[delta_list<0]='#F6C957'
    delta= ax.bar(x,delta_list,color=colors,width=0.4,)
    for index,value in enumerate(y1):
        if delta_list[index]>0:
            ax.text(index,delta_list[index]+0.01, f'{delta_list[index]*100:0.2f}%',  ha='center', va='bottom', color='#FBE8D5',fontsize=6,)
        else:
            ax.text(index,delta_list[index]-0.03, f'{delta_list[index]*100:0.2f}%',  ha='center', va='top', color='#FBE8D5',fontsize=6,)
    ax.axes.xaxis.set_visible(False)
    ax.axes.yaxis.set_visible(False)
    ax.axhline(y=0, linestyle='--', color=(194/255,127/255, 159/255), linewidth=1)
    ax.legend([delta],['完成率'],fontsize=6,ncol=2,loc='upper left')#'upper right',)

    ax  =axes[1]
    o1= ax.bar(x,y1,color='#ABD0F1',width=0.6,label='实际值')
    for index,value in enumerate(y1):
        ax.text(index,value+8, f'{value}',  ha='center', va='top', color='#E56F5E',fontsize=6,)
    o2= ax.bar(x,y2,color='#43978F',label='预估值')
    for index,value in enumerate(y2):
        ax.text(index,value+8, f'{value}',  ha='center', va='top', color='#E56F5E',fontsize=6,)
    ax.set_yticks([10*i for i in range(15)])
    ax.set_yticklabels([10*i for i in range(15)])
    ax.grid()
    mplcyberpunk.add_bar_gradient(bars=o1,ax =ax )
    mplcyberpunk.add_bar_gradient(bars=o2,ax =ax )
    ax.axes.yaxis.set_visible(False)
    axes[0].legend([o1,o2,delta,],['实际值','预估值','完成率'],fontsize=6,ncol=3,loc='upper right')#'upper right',)
    plt.subplots_adjust(hspace=0.01,wspace=0.01)
    plt.show()
输出效果图:
import pandas as pd
import seaborn as sns
import numpy as np
import mpl_font.noto
import matplotlib.pyplot as plt
import warnings
np.random.seed(2024)
df = pd.DataFrame({'2019':[42,21,53,16,23,10,20,65,16,34,13,25,18,25,14,26]})
df['Product'] = ['A_%d'%i for i in range(16)]
df['2020'] = df['2019'].apply(lambda x:x +30+ int(10*np.random.random()) )
df.loc[7,'2020']= 30

fig,ax = plt.subplots(figsize=(6,6),dpi=120,facecolor='white',edgecolor='white')
ax.set_facecolor('white')

#绘制线
ax.hlines(y=df.index+.03, xmin=df['2019'], xmax=df['2020'], color="k", lw=1)
#添加线标记
for i,v1,v2 in zip(df.index,df['2019'],df['2020']):
    if v2>v1:
        ax.text((v1+v2)/2,i+0.05,s="+%d"%(v2-v1),size=10,color='#ED1A1F',ha='left',va='bottom',fontweight='bold')
    else:
        ax.text((v1+v2)/2,i+0.05,s=v2-v1,size=10,color='#5CBB45',ha='left',va='bottom',fontweight='bold')

#绘制type_A散点
for i,j,text in zip(df.index,df['2019'],df['2019']):
    ax.scatter(j,i,s=30,color='k')

#绘制type_B散点
for i,j,text in zip(df.index,df['2020'],df['2020']):
    ax.scatter(j,i+.03,s=30,color='blue')
ax.set_xlim(left=-10,right=140)

#绘制竖线
ax.plot([0,0],[0,15],color='k',lw=1)

#绘制竖线上散点
for i in df.index:
    ax.scatter(0,i,color='#172A3A',ec='k',s=2,zorder=3)
for index,i in enumerate(zip(df.index,df['2020'],df['Product'])):
    if i[1] > 0 :
        ax.text(0-1,index,i[2],color='#3D71A0',size=8,ha='right',va='center')
    else:
        ax.text(i[1]-1,index,i[2],color='#3D71A0',size=8,ha='right',va='center')
ax.axis('off')

#添加图例
ax.scatter([],[],marker='o', label='2019',color="k")
ax.scatter([],[],marker='o', label='2020',color="blue")
ax.legend(loc='best',frameon=False,markerscale=1.2,ncol=1,prop={'size':8,},columnspacing=.5)
ax.invert_yaxis()
ax.set_title("不同产品在2019年~2020年销售额变化情况(滑珠图)")
可视化结果:
matplotlib_venn库(其官方github:https://github.com/konstantint/matplotlib-venn)是基于 matplotlib 开发的一个专门用来绘制维恩图(Venn Diagrams)的第三方扩展库主要绘制二维和三维韦恩图。下面是案例介绍。
from matplotlib import pyplot as plt
import numpy as np
import mpl_font.noto
from matplotlib_venn import venn3, venn3_circles,venn2
fig,axes = plt.subplots(1,2, figsize=(8,4))
ax = axes[0]
sv= venn2(ax=ax,subsets = [{1,2,3},{1,2,4}], set_labels = ('Set1', 'Set2'),set_colors=('r','b'))
# 调整标签字体大小
for text in sv.set_labels:
    text.set_fontsize(18)  # 设置集合名称的字体大小
for text in sv.subset_labels:
    text.set_fontsize(18)  # 设置交并集区域标签的字体大小
ax.set_title("简单2维韦恩图",fontsize=16, color='#AA55FF')

ax = axes[1]
v = venn3(ax=ax,subsets=(1, 1, 1, 1, 1, 1, 1), set_labels = ('A', 'B', 'C'))
v.get_patch_by_id('100').set_alpha(1.0) #设置透明度
v.get_patch_by_id('100').set_color('white') #设置区域颜色
v.get_label_by_id('100').set_text('1:10%') #设置区域显示文本
v.get_label_by_id('100').set_color('#EA8379') #设置区域内的颜色
v.get_label_by_id('A').set_text('Set "A"') #设置区域内标签内容
v.get_label_by_id('B').set_fontsize(18) #设置B区域内标签的大小
v.get_patch_by_id('A').set_linestyle('dashed') #设置线圈格式
v.get_patch_by_id('A').set_linewidth(2) #设置线圈格式
v.get_patch_by_id('A').set_edgecolor('#547DB1') #设置外圈
c = venn3_circles(ax=ax,subsets=(1, 1, 1, 1, 1, 1, 1),
                  linestyle='--', # 'dashed'
                  linewidth=0.8,
                  color="black" # 外框线型、线宽、颜色
                 )

c[0].set_lw(1.0)
c[0].set_ls('dotted')

ax.annotate('Unknown set', xy=v.get_label_by_id('100').get_position() - np.array([0, 0.05]), xytext=(-70,40),
             ha='center', textcoords='offset points', bbox=dict(boxstyle='round,pad=0.5', fc='gray', alpha=0.1),
             arrowprops=dict(arrowstyle='->', connectionstyle='arc3,rad=0.5',color='gray'))

ax.annotate('great job',color='#547DB1',
            xy=v.get_label_by_id('001').get_position() - np.array([0, 0.05]),
            xytext=(-50,-30),
            ha='center',
            textcoords='offset points',
            bbox=dict(boxstyle='round,pad=0.5', fc='#547DB1', alpha=0.1),
            arrowprops=dict(arrowstyle='->', connectionstyle='arc3,rad=0.5',color='#547DB1'))

ax.annotate('green part',color='#098154',
            xy=v.get_label_by_id('010').get_position() - np.array([0, 0.05]),
            xytext=(50,40),
            ha='center',
            textcoords='offset points',
            bbox=dict(boxstyle='round,pad=0.5', fc='#098154', alpha=0.1),
            arrowprops=dict(arrowstyle='-|>', connectionstyle='arc3,rad=-0.4',color='#098154'))
ax.set_title("3维韦恩图效果展示",fontsize=16, color='#AA55FF')
fig.suptitle("恩图效果展示",fontsize=20,color='#D52AFF')
plt.show()
可视化效果:

UpSet图(UpSet Plot)是一种现代化的多集合并集可视化工具,它有效地解决了传统二维韦恩图(Venn diagram)在展示高维度集合关系时的局限性,尤其是在处理大量集合及其交集时的优势更为明显。可以看出韦恩图在高维数据的扩展。
from upsetplot import UpSet
fig= plt.figure(figsize=(10,6),dpi=100)
upset = UpSet(ds,sort_by='cardinality',
              intersection_plot_elements=6,
              totals_plot_elements=3,
              element_size=None,
              show_counts=True,
             facecolor= 'black'
             )
# 设置左边的总量对应类别地样式
upset.style_categories(categories="cat0", shading_facecolor="lavender",
                       bar_edgecolor='black',
                       bar_facecolor ='red',
                       bar_hatch="/",
                      shading_linewidth=1)
upset.style_categories(
    categories=["cat2","cat1"],
   bar_facecolor="aqua", bar_hatch="xx", bar_edgecolor="black"
)

#设置最上面和中间散点图的柱状图样式: 只要满足cat1
upset.style_subsets(present="cat1",  facecolor="#AA55FF", linewidth= 0.9)
#只要满足cat0
upset.style_subsets(present="cat0",  facecolor="#807FFF", linewidth= 0.9)

#设置cat1和cat2设置为蓝色
upset.style_subsets(present=["cat1", "cat2"], facecolor="blue",  hatch="xx", edgecolor='black')
#>=3000以上的设置为浅蓝色
upset.style_subsets(min_subset_size=3000, facecolor="#D52AFF", hatch="*",edgecolor='black',label='>3k')


#设置最上面和中间散点图的柱状图样式: 按照degree来设置
upset.style_subsets(max_degree=0, facecolor="#55AAFF" ,hatch="",edgecolor='black',label='度为0')
# upset.style_subsets(min_degree=2, facecolor="purple")

axes=upset.plot(fig=fig)
# 将最右边的图中关闭网格
axes['totals'].grid(False)
axes['intersections'].grid(False)
# 设置最上面柱状图的y轴标签
axes['intersections'].set_ylabel("度量值", fontsize=14)
# 关闭最上面柱状图的图例
axes['intersections'].legend(frameon=False)
# 设置最右边柱状图的x轴标签
axes['totals'].set_xlabel("总量", fontsize=14)
plt.suptitle("UpSet图可视化展示",fontsize=20)
plt.show()
输出的结果:
plottable库(其官方github:https://github.com/znstrider/plottable)是专门可视化表格展示的神器,其底层是基于matplotlib开发的,展示效果惊艳,修改代码少,非常好用。
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
from matplotlib.colors import LinearSegmentedColormap
import mpl_font.noto
from plottable import ColumnDefinition, Table
from plottable.formatters import decimal_to_percent
from plottable.plots import bar, percentile_bars, percentile_stars, progress_donut
# cmap = LinearSegmentedColormap.from_list(
#     name="bugw", colors=["#ffffff", "#f2fbd2", "#c9ecb4", "#93d3ab", "#35b0ab"], N=256
# )
np.random.seed(2024)
pf = pd.DataFrame(np.random.random((5, 4)), columns=["A", "B", "C", "D"]).round(2)
pf.index.set_names("序号",inplace=True)

fig, axes = plt.subplots(1,2,figsize=(10,5),dpi=100)
Table(pf,ax=axes[0]
            ,odd_row_color="#f0f0f0"
            , even_row_color="#e0f6ff"
           )
axes[0].set_title("原始数据如下")

Table(pf
        ,ax=axes[1],
        cell_kw={
            "linewidth": 0,
            "edgecolor": "k",
        },
        textprops={"ha": "center"},
        column_definitions=[
            ColumnDefinition("index", textprops={"ha": "left"}),
            ColumnDefinition("A", plot_fn=percentile_bars, plot_kw={"is_pct": True}),
            ColumnDefinition(
                "B", width=1.5, plot_fn=percentile_stars, plot_kw={"is_pct": True}
            ),
            ColumnDefinition(
                "C",
                plot_fn=progress_donut,
                plot_kw={
                    "is_pct": True,
                    "formatter": "{:.0%}"
                    },
                ),
            ColumnDefinition(
                "D",
                width=1.25,
                plot_fn=bar,
                plot_kw={
                    "cmap":  plt.cm.cool,
                    "plot_bg_bar": True,
                    "annotate": True,
                    "height": 0.5,
                    "lw": 0.5,
                    "formatter": decimal_to_percent,
                },
            ),
        ],
)
axes[1].set_title("经过精美化后数据展示")
plt.show()
输出结果:
基于Great_tables库(https://posit-dev.github.io/great-tables/get-started/basic-header.html),任何人都可以在Python中轻松创建出外观精美的表格,下面是一个python案例展示。
out=(
     GT(pl.from_pandas(pf))
      .tab_header(
        title = md("使用great_tables来绘制迷你图样式汇总"),
        subtitle = "包含折线图、柱状图、横向柱状图、点棒图"
    )
    .opt_align_table_header(align="center")
    .fmt_nanoplot(columns="string_number"
                  , plot_type="bar"
                ,reference_line="max"
                ,reference_area=["q1", "q3"]
            ,options=nanoplot_options(
            data_point_radius=8,
            data_point_stroke_color="black",
            data_point_stroke_width=2,
            data_point_fill_color="white",
            data_line_type="straight",
            data_line_stroke_color="brown",
            data_line_stroke_width=2,
            data_area_fill_color="orange",
            vertical_guide_stroke_color="green",
        ),
    )
    #reference_line in ("mean", "median", "min", "max", "q1", "q3", "first", or "last")
    .fmt_nanoplot(columns="numbers",
                  reference_line="max",
                  reference_area=["q1", "q3"],
                  autoscale=True)
    .fmt_nanoplot(columns="hbar_number", plot_type="bar")
    .fmt_nanoplot(columns="lines")
    .fmt_nanoplot(
        columns="temperatures",
        plot_type="line",
        expand_x=[5, 16],
        expand_y=[10, 40],
        options=nanoplot_options(
            show_data_area=False,
            show_data_line=False
        )
    )
    .cols_label(
        example=html("索引"),
        string_number=html("面积柱状图"),
        numbers=html("面积折线图"),
        temperatures=html("点状图"),
        hbar_number=html("横向柱状图"),
        lines=html("点棒图"),
    )
    .cols_align(align="center", columns="lines")
    .tab_source_note(
        source_note="Source:本图由Z先生的备忘录制作"
    )
    .tab_source_note(
        source_note=md("Reference: https://posit-dev.github.io/great-tables/get-started/")
    )
)
out
可视化展示:
dtreeplot库(其github:https://github.com/suyin1203/dtreeplot)是一款简易的决策树可视化库,只需要使用少量的代码就可以展示树模型结构,下面是一个简单的python案例精美展示决策树模型。
import sklearn
print("sklearn: ", sklearn.__version__) # sklearn:  1.2.2
from dtreeplot import model_plot
from sklearn import datasets
from sklearn.tree import DecisionTreeClassifier

X, y = datasets.make_classification(n_samples=30000,
                                    n_features=10,
                                    weights=[0.96, 0.04],
                                    random_state=5)
features = [f'Var{i+1}' for i in range(X.shape[1])]


clf = DecisionTreeClassifier(criterion='gini',
                             max_depth=3,
                             min_samples_split=30,
                             min_samples_leaf=10,
                             random_state=2024)
model = clf.fit(X, y)

model_plot(model, features, labels=y, height=530)
树模型可视化结果:
显示中文字体:
#第一步:先将对应的js文件拷贝到当前目录
# !git clone https://github.com/suyin1203/dtreeplot
# !mv dtreeplot/dtreeplot/* ./
# !rm -rf dtreeplot

#第二步:修改model_plot函数中的_plot_tree函数
html_content = string.Template("""
<meta charset="UTF-8">
...
""")
#第三步:设置显示的特征名称为中文,并执行结果
features = [f'特征{i+1}' for i in range(X.shape[1])]
树模型可视化结果(显示中文字体):
dtreeviz(其github:https://github.com/parrt/dtreeviz)是一款精美的树模型可视化库,是基于matplotlib库的二次开发的,其通过一行代码就快速展示树模型的结果。下面是一个简单的python案例展示决策树模型结果。
!pip install dtreeviz==1.3.2
import dtreeviz
print("dtreeviz:", dtreeviz.__version__) # dtreeviz : 1.3.2
from sklearn.datasets import load_iris
from sklearn.tree import DecisionTreeClassifier, DecisionTreeRegressor
from dtreeviz.trees import dtreeviz
from PIL import Image
import numpy as np

iris = load_iris()
clf = DecisionTreeClassifier(max_depth=5)  # limit depth of tree
iris = load_iris()
clf.fit(iris.data, iris.target)

from mplfonts.util.manage import use_font
fontname='Noto Sans CJK SC'
use_font(fontname)
viz = dtreeviz(clf,
               iris['data'],
               iris['target'],
               target_name='',
               feature_names=np.array(iris['feature_names']),
               class_names={0: '类别1', 1: '类别2', 2: '类别3'}, scale=1.5,
               orientation='LR'
               ,fontname= fontname
               )  # ('TD', 'LR')
viz
输出结果:
pybaobabat(其github: https://github.com/dmikushin/pybaobab)是模拟树结构过程的一款可视化库,是基于matplotlib库进行二次扩展的,其可以快速展示树模型的结果。下面是一个简单的python案例展示决策树模型结果。
#!pip install pybaobabdt==1.0.1 pygraphviz==1.12
import pybaobabdt
from matplotlib.colors import ListedColormap
ax = pybaobabdt.drawTree(clf,
         size=10,
         dpi=100,
         maxdepth=6, #设置渲染的树的最大深度
         colormap=ListedColormap(["#01a2d9", "gray", "#d5695d","gray"]),
         features=np.array(iris['feature_names']))
输出结果:
在数据分析中,经常会对某个指标进行各个维度的拆解,这是通过指标拆解树可以清楚看到某度量指标在不同维度下的占比情况和整体的分布情况。
通过对绘图源码进行拆解发现其主要分为2部分;
plotter_js_path ='./js/plotter.js'
with open(plotter_js_path, 'r', encoding='utf-8') as f:
    plotter_js_content = f.read()
container_id = "tree_plot_contid_" + uuid.uuid4().hex
# Converts the tree into its json representation.
features = [f'特征{i+1}' for i in range(X.shape[1])]
json_tree = _tree_to_json(model, features, y)
json_tree
对应的
{
  'value': {'type': 'PROBABILITY','distribution': [0.9552, 0.0448], 'num_examples': '30000,4.48%'},
 'condition': {'type': 'NUMERICAL_IS_HIGHER_THAN', 'attribute': '特征6', 'threshold': 0.6037},
 'children': [
 {'value': {'type': 'PROBABILITY', 'distribution': [0.314, 0.686], 'num_examples': '1309,68.60%'},
   'condition': {'type': 'NUMERICAL_IS_HIGHER_THAN','attribute': '特征5','threshold': -0.2251}
  ]
  ....
}

修改plotter.js文件中display_conditiong函数如下:
json_tree ={'value': {'type': 'PROBABILITY', 'distribution': [1, 0], 'num_examples': '3000,100%'},
            'condition': {'type': 'NUMERICAL_IS_HIGHER_THAN', 'attribute': '总销售量'},
            'children': [
                {'value':{'type': 'PROBABILITY', 'distribution': [0.70, 0.30], 'num_examples': '2100,70%'},
                 'condition': {'type': 'NUMERICAL_IS_HIGHER_THAN','attribute': '产品A','threshold': -0.2251},
                  'children': [{'value': {'type': 'PROBABILITY',
                    'distribution': [1,0],
                    'num_examples': '城市A:2100,100%'}}]
               },
              {'value': {'type': 'PROBABILITY','distribution': [0.20, 0.80],'num_examples': '600,20%'},
               'condition': {'type': 'NUMERICAL_IS_HIGHER_THAN','attribute': '产品B','threshold': 1.3376},
               'children': [{'value': {'type': 'PROBABILITY',
                    'distribution': [0.60, 0.40],
                    'num_examples': '城市A:360,60%'}},
                  {'value': {'type': 'PROBABILITY',
                    'distribution': [0.40, 0.60],
                    'num_examples': '城市B:240,40%'}}]
              },
            {'value': {'type': 'PROBABILITY','distribution': [0.10, 0.90],'num_examples': '300,10%'},
             'condition': {'type': 'NUMERICAL_IS_HIGHER_THAN','attribute': '产品C', 'threshold': -1.0981},
             'children': [{'value': {'type': 'PROBABILITY',
                'distribution': [0.90, 0.10],
                'num_examples': '城市A:270,90%'}},
              {'value': {'type': 'PROBABILITY',
                'distribution': [0.1815, 0.8185],
                'num_examples': '城市B:30,10%'}}]}
    ]
}

joyplot库(其官方github: https://github.com/leotac/joypy)是一个专为Python用户设计的数据可视化工具,主要用于绘制一种名为“峰峦图”(Ridgeline Plots)或简称“Joyplot”的特殊类型的图表。这种图表类型以其独特的美学和信息传达能力而受到青睐,它通过叠加多个核密度估计曲线来展示多个变量或多个类别数据的分布情况。其他用法可以访问其github仓库。下面是案例展示
下面是利用joyplot库来绘制山脊图,其可以展示3维的数据,并较直观的进行两两对比。
# !pip install joypy==0.2.6
import joypy
import pandas as pd
import numpy as np
import matplotlib
from matplotlib import pyplot as plt
from matplotlib import cm
from sklearn.datasets import load_iris
iris, y = load_iris(as_frame=True, return_X_y=True)
iris.columns = ["SepalLength","SepalWidth","PetalLength","PetalWidth"]
iris["Name"] = y.replace([0,1,2], ['setosa', 'versicolor', 'virginica'])

fig, axes = joypy.joyplot(iris,colormap= plt.cm.cool)
plt.cm.cool

%matplotlib inline
fig, axes = joypy.joyplot(iris, by="Name", column="SepalWidth",
                          hist=True, bins=20, overlap=0,
                          grid=True, legend=False)
效果展示:
Pynimate是一个专为Python设计的第三方数据可视化库(其官方github:https://github.com/julkaar9/pynimate),它主要用于创建动态图表和动画,特别适用于显示随时间变化的数据序列,例如动态柱状图、排序图等。
# !pip install pynimate==1.3.0
import pandas as pd
from matplotlib import pyplot as plt
import pynimate as nim
import mpl_font.noto
import numpy as np
%matplotlib inline
df = pd.DataFrame(
    {
        "time": ["1960-01-01", "1961-01-01", "1962-01-01"],
        "巴西": [1, 3, 5],
        "日本": [2, 3, 7],
        "韩国": [4, 2, 9],
        "法国": [5, 3, 10],
        "印度": [1, 4, 14],
    }
).set_index("time")

my_fig = nim.Canvas(nrows=1, ncols=2, figsize=(12,7))
#配置柱状图
barh = nim.Barhplot.from_df(data=df.copy(), time_format="%Y-%m-%d"
                   , ip_freq="2d"
                   ,annot_bars=True
                   ,rounded_edges=True
                   ,xticks=True
                   ,yticks=True
                   ,grid=False
                )
barh.set_title("各国的变化趋势")
barh.set_bar_annots(color="#547DB1", size=13)
barh.set_bar_border_props(edge_color="#547DB1",radius=0.3, pad=0.4, mutation_aspect=0.5)
barh.set_time(x=0.92
              ,y=0.2
              ,callback=lambda i, datafier: datafier.data.index[i].strftime("%Y-%m")
              ,size=24)
barh.set_text(
    "sum",
    callback=lambda i, df: f"总和:{np.round(df.data.iloc[i].sum(),2)}",
    size=20,
    x=0.72,
    y=0.13,
    color="#547DB1",
)
bar = nim.Barhplot.from_df(data=df.copy(), time_format="%Y-%m-%d"
                   , ip_freq="2d"
                   ,palettes=['cool'] #配置颜色
                   ,annot_bars=True  #显示柱状图标签
                   ,rounded_edges=True #显示柱状图是否呈现圆形
                   ,xticks=True  #显示x轴刻度
                   ,yticks=True   #显示y轴刻度
                   ,grid=False     #是否显示网格
                )
bar.set_title("各国的变化趋势")
bar.set_bar_annots(color="#547DB1", size=13)
bar.set_bar_border_props(edge_color="#547DB1",radius=0.3, pad=0.4, mutation_aspect=0.5)
bar.set_time(x=0.92,y=0.2,callback=lambda i, datafier: datafier.data.index[i].strftime("%Y-%m"),size=24)
bar.set_text(
    "sum",
    callback=lambda i, df: f"总和:{np.round(df.data.iloc[i].sum(),2)}",
    size=20,
    x=0.72,
    y=0.13,
    color="#547DB1",
)

# my_fig.ax 获得matplotlib的ax
my_fig.ax[0][0].spines["top"].set_visible(False)
my_fig.ax[0][0].spines["right"].set_visible(False)
my_fig.ax[0][0].spines["bottom"].set_visible(False)
my_fig.ax[0][0].spines["left"].set_visible(False)
my_fig.ax[0][1].spines["top"].set_visible(False)
my_fig.ax[0][1].spines["right"].set_visible(False)
my_fig.ax[0][1].spines["bottom"].set_visible(False)
my_fig.ax[0][1].spines["left"].set_visible(False)

my_fig.add_plot(barh,index=(0,0))
my_fig.add_plot(bar,index=(0,1))
my_fig.animate()
my_fig.save(filename="demo", fps=24, extension="gif")
plt.show()
效果展示:
今天给大家分享数据分析中,高达17种高级图表可视化技术,并附带详细的python案例,干货满满。大家在实际的业务数据,选择合适的图表进行展示~
如果本文对你有帮助,还请你点赞在看转发。你的支持就是我创作的最大动力,关注下面公众号不迷路~
👉往期文章精选


